Quienes trabajamos en análisis de datos dentro del mundo SAP tendemos, en ocasiones, a definir SAP Datasphere simplemente como el sucesor de SAP BW o como un nuevo data warehouse en la nube. Sin embargo, su alcance es bastante mayor. La plataforma se apoya en SAP HANA como motor de datos y combina capacidades de integración, modelado y analítica con una capa semántica orientada al negocio.
Este último concepto resulta especialmente familiar para quienes procedemos de SAP BusinessObjects y del trabajo con universos, donde uno de los objetivos principales era abstraer la complejidad técnica de las fuentes de datos y presentarla mediante conceptos, relaciones y terminología comprensibles para los usuarios de negocio.
MUCHOS TIPOS DE OBJETOS, NADA SOBRA (o casi nada)
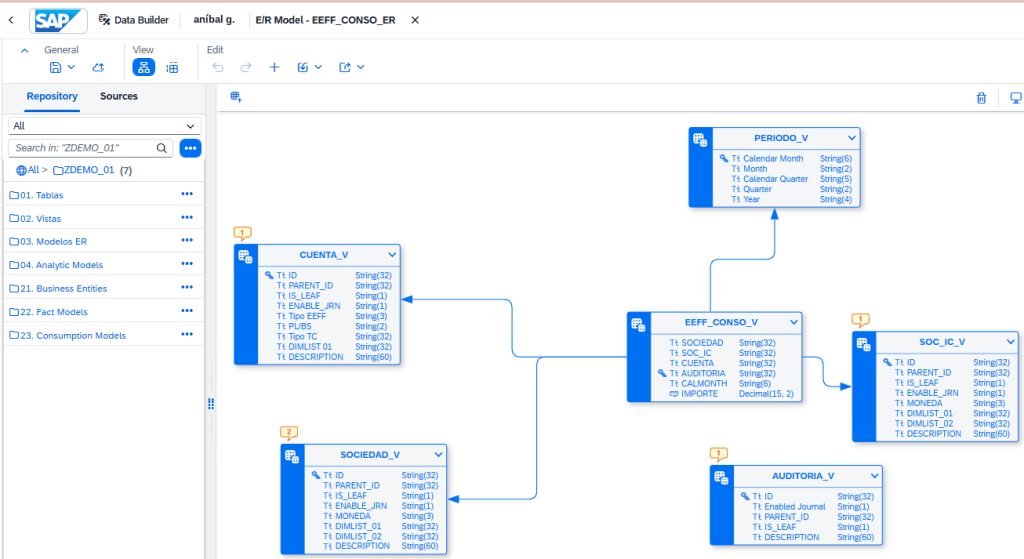
En SAP Datasphere, tanto en Data Builder como en Business Builder, conviven distintos tipos de objetos que se relacionan entre sí y cumplen funciones complementarias. Su valor no está en usarlos de forma aislada, sino en entender cómo encajan dentro de un modelo coherente: cada componente aporta una pieza necesaria para construir soluciones más sólidas, evolutivas y reutilizables.
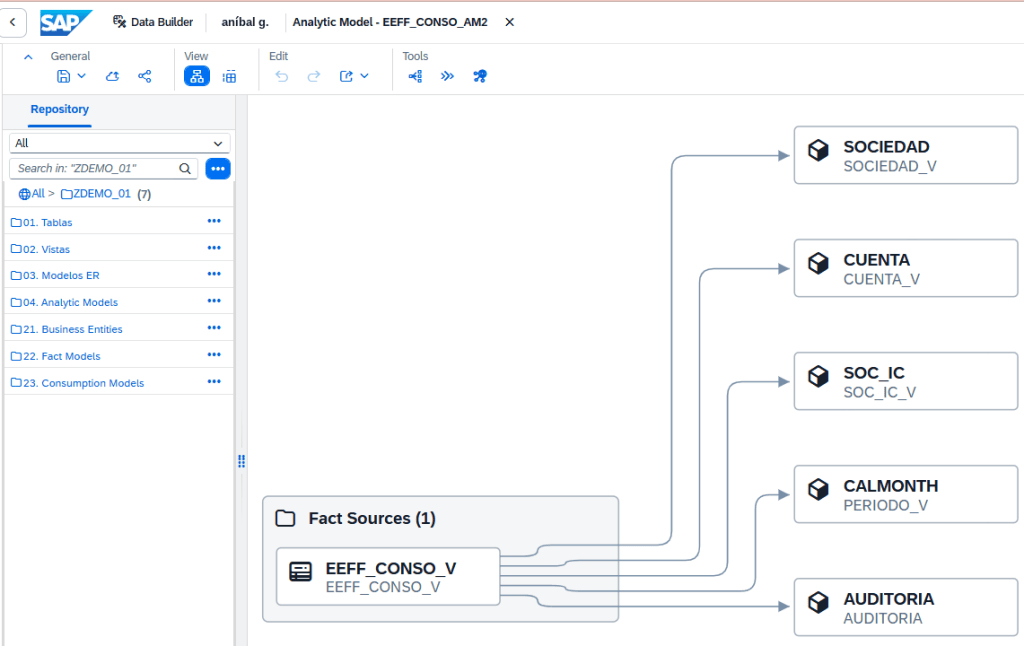
El recorrido típico comienza en las tablas, que pueden representar dimensiones, como datos maestros, o hechos, como movimientos. Cuando es necesario, las dimensiones se enriquecen con jerarquías y textos dependientes del idioma. A partir de ahí se construyen las vistas, que agrupan subconjuntos lógicos de información y permiten combinar hechos, jerarquías y textos en modelos analíticos. Finalmente, la información se expone mediante una capa semántica o de consulta, por ejemplo, Analytic Models o Perspectivas basadas en Consumption Models, que actúa como punto de acceso para herramientas como SAP Analytics Cloud (SAC), SAP BusinessObjects, SAP Analysis for Office u otras soluciones externas a SAP.
EN SAP BW PARECÍA TODO MÁS FÁCIL
En SAP Business Warehouse (SAP BW), construir un modelo podía resultar más directo. No era necesario crear tantos elementos ni definir tantas asociaciones entre ellos, y el margen de maniobra era mayor. En muchos casos bastaba con preparar una serie de objetos, incorporarlos a un DSO (o a un cubo en versiones más antiguas) y disponer en poco tiempo de un modelo prácticamente operativo.
En SAP Datasphere, en cambio, el modelo se descompone en más piezas y exige definir un mayor número de asociaciones. Esa separación puede ralentizar una necesidad puntual, pero también permite reutilizar componentes en escenarios posteriores. Por eso, frente a la rapidez inicial de SAP BW, el valor de SAP Datasphere aparece con más claridad a medio y largo plazo, cuando las mismas piezas sirven para responder a nuevas necesidades de negocio sin reconstruir el modelo desde cero.
CÓMO SE ESTÁN HACIENDO LAS COSAS (nuestro parecer)
En nuestra experiencia con SAP Datasphere, hemos participado en algunos proyectos y, en ocasiones, hemos encontrado desarrollos ya iniciados con una organización poco clara. Esta situación puede deberse a la cantidad de objetos disponibles en la plataforma, a la relativa novedad de la herramienta o a hábitos heredados de SAP BW y de otras tecnologías.
Lo que observamos habitualmente es un patrón parecido: se importa una fuente de datos basada en una CDS estándar, normalmente con un número elevado de columnas; en algunos casos se construyen megatablas; y desde ahí se crean vistas que se consumen directamente, sin aprovechar buena parte de los objetos y funcionalidades que ofrece la plataforma. Las fuentes de información suelen provenir directamente de sistemas SAP mediante CDS estándar, cuando podrían definirse CDS a medida para reducir el volumen de datos y concretar mejor las necesidades reales del negocio.
Como sugerencia, planteamos lo siguiente:
- Identificar bien las fuentes de datos y optimizarlas en origen, por ejemplo mediante CDS personalizadas que incluyan solo las columnas necesarias para la explotación y realicen las combinaciones lógicas requeridas entre las tablas fuente. Hay que tener presente que las CDS son definiciones lógicas y que, si están bien construidas, pueden reducir los tiempos de ingesta y mejorar la claridad del modelo.
- Definir estándares para la identificación técnica de la serie de objetos que se van a construir.
- Hacer uso de paquetes y carpetas para organizar los objetos.
- Evitar el abuso de tablas o vistas definidas directamente por importación, para mantener mayor control sobre la naturaleza de los datos que se van a tratar.
- Hacer un uso adecuado de los distintos objetos disponibles para almacenar los datos, en lugar de recurrir siempre al mismo por comodidad.
- Ofrecer al usuario final el acceso a los datos mediante modelos analíticos o perspectivas, y no a través de tablas o vistas técnicas. Estas últimas no están pensadas como capa de consumo final y, si se utilizan de ese modo, se desaprovechan capacidades importantes de análisis multidimensional de la plataforma.
En conclusión, SAP Datasphere no debe abordarse como una simple evolución de SAP BW, sino como una plataforma que exige plantear mejor la arquitectura desde el inicio. Su mayor valor aparece cuando se entienden sus objetos, se ordena el modelo desde el inicio y se construyen soluciones pensadas para ser reutilizadas, gobernadas y consumidas por el negocio.
 aníbal goicochea
